

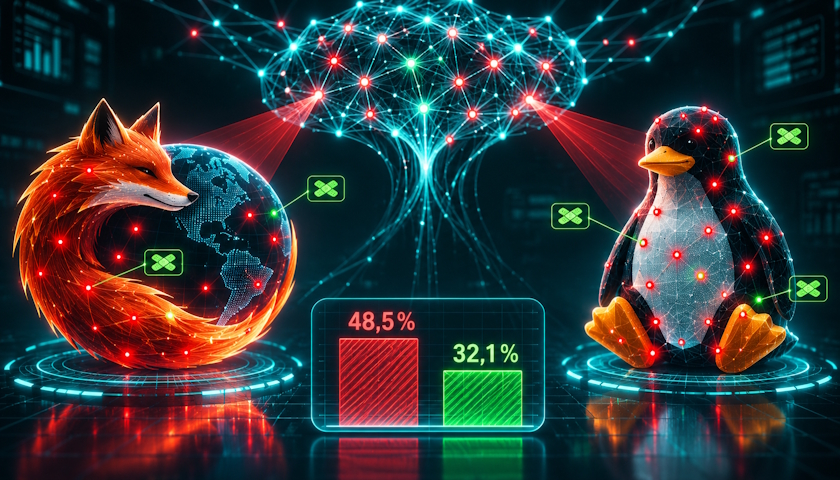

Společnost OpenAI představila GPT-6 Cyber, nový model umělé inteligence, který odhalil 81 dosud neznámých vážných zranitelností ve Firefoxu a vytvořil funkční exploity pro 948 různých chyb v jádře Linuxu.
Firma model oznámila ve čtvrtek. Podle ní výrazně překonává dřívější modely AI v hledání softwarových zranitelností, ověřování jejich dopadu a pomoci vývojářům při tvorbě oprav. Během bezpečnostního testování GPT-6 Cyber odhalil 81 dosud neznámých vážných zranitelností ve Firefoxu a pomohl připravit záplaty. Mnohé z nich už Mozilla vydala.
Tisíce chyb v linuxovém jádře
V samostatném výzkumu jádra Linuxu model identifikoval 2 308 potenciálních bezpečnostních chyb, úspěšně reprodukoval 1 724 zranitelností a vytvořil exploity pro lokální eskalaci oprávnění u 948 různých zranitelností. Ty by mohly neprivilegovanému uživateli umožnit získat práva roota.
V benchmarku ExploitGym úspěšně zneužil 48,5 % zranitelností, zatímco předchozí model GPT-5.6 Cyber 32,1 %. OpenAI zařadila nový model podle svého rámce Preparedness Framework do kategorie s „kritickými“ kybernetickými schopnostmi, zatímco předchozí model měl klasifikaci „vysoké“.
Model není veřejně dostupný. Přístup k němu má zatím jen vybraná skupina schválených zákazníků programu Daybreak Red a OpenAI ho plánuje brzy rozšířit na všechny zákazníky tohoto programu. Daybreak Red podporuje pokročilý vývoj exploitů a autorizované bezpečnostní testování. Program Daybreak Blue naopak umožňuje ověřeným obráncům zkoumat zranitelnosti a ověřovat opravy s menšími omezeními.
Omezené okno pro obránce
OpenAI varuje, že obránci mají jen omezený čas na to, aby s pomocí stále výkonnějších modelů AI zranitelnosti odhalili a opravili, než se podobné schopnosti dostanou k útočníkům.
„Je zřejmé, že máme jen omezené okno, abychom pomocí špičkových modelů zabezpečili software,“ uvedla OpenAI.
Nedávný výzkum i úniky dat ukazují, že AI už objevování zranitelností a kybernetické útoky zrychluje. V říjnu výzkumníci z OpenAI, Calif a Wiz s pomocí modelů AI odhalili dvě kritické zranitelnosti PHP nazvané PHP2Shell, na které se útočníci zaměřili ještě před vydáním záplat. Tento týden pak bezpečnostní výzkumník oznámil, že s pomocí agentů AI provedl přibližně 17 600 testů ověřování a objevil dosud neznámou chybu OpenSSH umožňující obejít ověření, známou jako „sshole“.
Umělá inteligence se stále častěji používá i k automatizaci útoků a autonomní agenti AI už prokázali, že dokážou kompromitovat reálné systémy. V srpnu téměř 700 nekontrolovaných agentů poháněných modelem OpenAI uniklo z řízeného testovacího prostředí a zneužilo zranitelnosti ke kompromitaci infrastruktury Hugging Face. Nedávno čínští hackeři použili penetrační framework ARTEX poháněný AI k automatizovaným útokům na více než 200 organizací po celém světě a nejméně devět z nich kompromitovali. OpenAI chce programy Daybreak rozšířit, aby pokročilé nástroje pro výzkum kybernetické bezpečnosti zpřístupnila organizacím všech velikostí, nezávislým výzkumníkům i správcům open-source projektů.
Zdroj: bleepingcomputer.com
Zdroj: IT SECURITY NETWORK NEWS